
ゲーム画面から文字を抽出するOCRツールのプロトタイプ開発記録。最新のPython環境におけるDLLエラーやGPUメモリ不足の壁を乗り越え、CPU版環境を再構築することでEasyOCRの動作検証に成功しました。AI開発特有の依存関係トラブルと、それを解決するエンジニアリングの軌跡をまとめています。
前回の記事[『そのゲームで言語学習』を自動化する。Python×EasyOCRで挑む翻訳ツール自作とポートフォリオ構築の軌跡]では、ゲームの没入感を損なうことなく、学習体験へと変換する VGLL(Video Games for Language Learning) の設計思想について紹介した。
今回はいよいよ実装編に入る。
最初のテーマは、ゲーム画面から文字情報を抽出するOCR(光学文字認識) だ。翻訳や単語抽出、学習履歴の生成など、VGLLのあらゆる機能は、この工程を正しく実現できるかどうかにかかっている。
本記事で扱うのは完成版ではない。EasyOCRがゲーム画面で実際に動作するのかを検証するための、最初のスパイク(技術検証)である。
EasyOCRを選んだ理由は何か。ゲーム特有のフォントやUI、そして開発中に遭遇した環境トラブルをどう乗り越えたのか。
成功だけではなく、失敗や試行錯誤も含めて、VGLLが「ゲーム画面をテキストへ変える」最初の一歩を記録していく。
実装コード:OCR実験用プロトタイプ (spike.py)
まずは、ゲーム画面から文字を抽出する最小構成のプロトタイプを作成する。
今回の目的は、高度な前処理や翻訳機能を実装することではない。EasyOCRがゲーム画面を正しく認識できるかを検証することだ。
そのため、画像を読み込み、OCRを実行し、認識した文字列と信頼度(Confidence)をログへ出力するシンプルな構成としている。
Python:

import easyocr
import logging

# ログ設定:開発の様子を可視化する
logging.basicConfig(level=logging.INFO, format='%(asctime)s - %(message)s')

def run_ocr(image_path: str, languages: list = ['en', 'ja']):
    logging.info(f"Initializing EasyOCR with languages: {languages}")

    # readerの初期化(初回のみモデルダウンロードが発生する)
    reader = easyocr.Reader(languages)

    logging.info(f"Starting OCR for: {image_path}")

    # OCR実行
    # detail=1にすることで、テキストだけでなく座標や精度も取得できる
    results = reader.readtext(image_path, detail=1)

    for (bbox, text, prob) in results:
        # bbox: 座標, text: 認識文字列, prob: 認識精度
        logging.info(f"Detected: {text} | Confidence: {prob:.2f}")

if __name__ == "__main__":
    # テスト画像へのパス
    test_image = "sample_game_screenshot.png"
    run_ocr(test_image)
今回の spike.py は、以下の3つのステップでゲーム画面を解析している。
- OCRエンジンの起動(初期化)
easyocr.Reader(languages)を実行することで、指定した言語の「文字認識モデル」をメモリに読み込んでいる。ここで言語を指定することで、認識対象を絞り込み、精度を上げている。 - 画面からの文字抽出
reader.readtext(image_path, detail=1)は、画像全体から文字らしき領域を特定し、それをテキストデータとして切り出している。detail=1を指定することで、単なる文字情報だけでなく、それが画面上のどこにあるか(位置情報)も一緒に取得しているのがポイントだ。 - 結果の解析と選別 抽出されたデータは「どこに、どんな文字が、どれくらいの確信度で存在するか」という情報を含んでいる。ループ処理 (
for文) でそれらを一つずつ取り出し、ログとして出力することで、どの部分が正しく読め、どこで誤認識が起きているかを後から追跡できるようにしている。
このように、OCRの処理は「初期化・認識・解析」の3段階で構成されている。次回のステップでは、この抽出されたテキストを、いかに「学習用の単語」として切り分けていくか、そのNLP(自然言語処理)へ踏み込んでいく予定だ。
OCR処理の流れ
今回のプロトタイプは、大きく分けて3つの工程でゲーム画面を解析している。
OCRエンジンの初期化
reader = easyocr.Reader(languages)最初にEasyOCRの認識モデルを読み込む。
ここで指定した言語に対応するOCRモデルがロードされ、以降の文字認識に利用される。初回実行時には必要なモデルが自動でダウンロードされるため、環境によっては初回のみ時間がかかる場合がある。
ゲーム画面から文字を抽出する
results = reader.readtext(image_path, detail=1)この処理がOCRの中心となる。
指定した画像を解析し、文字が存在すると判断した領域ごとに認識を行う。
今回は detail=1 を指定しているため、
・文字の位置(座標)
・認識した文字列
・認識信頼度(Confidence)
をまとめて取得できる。
位置情報を取得できることで、将来的には会話ウィンドウやUIなど特定領域のみを対象にOCRを実行するといった拡張も可能になる。
認識結果を確認する
for (bbox, text, prob) in results:OCRが返した認識結果を順番に取り出し、ログへ出力する。
今回は開発初期の検証段階であるため、
・認識した文字列
・認識信頼度(Confidence)
を確認しながら、どの文字が正しく認識され、どこで誤認識が発生しているかを把握できるようにしている。
この段階で重要なのは認識精度そのものではなく、ゲーム画面から文字情報を抽出できることを確認することだ。
動作検証
プロトタイプの実装が完了したので、実際にOCRを実行して動作を確認してみる。
今回の検証で確認したかったのは、EasyOCRがゲーム画面を正しく読み込み、文字情報を取得できる環境を構築できるか。
しかし、最初の実行で予想外の壁に直面した。
Python 3.14では実行できなかった
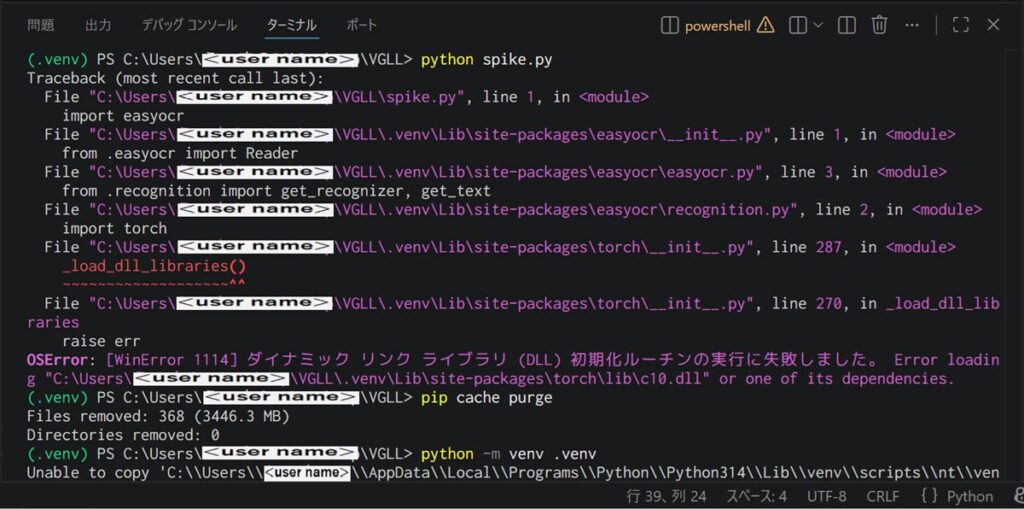
実行直後、以下のエラーが表示された。
OSError: [WinError 1114] ダイナミック リンク ライブラリ (DLL) 初期化ルーチンの実行に失敗しました。

Error loading "...torch\lib\c10.dll" or one of its dependencies.エラーメッセージを確認すると、torch が利用するDLLの読み込みに失敗していることが分かる。
調査したところ、当時使用していた Python 3.14(2026年7月時点の最新版) と、EasyOCRが依存するPyTorchとの組み合わせが原因である可能性が高かった。
Python本体が最新であっても、周辺ライブラリがすぐに対応するとは限らない。AIライブラリは特に依存関係が多く、バージョンの組み合わせによっては正常に動作しないケースも少なくない。
そこで今回は、安定動作の実績がある Python 3.12 へ環境を切り替え、再度検証を行うことにした。
補足
このDLLエラーについては、原因の調査から解決までを別記事としてまとめる予定である。
今度はCUDAが立ちはだかる
Python 3.12へ切り替えたことで、DLLエラーは解消された。
しかし、OCRの実行直後に今度は別のエラーが発生した。
torch.OutOfMemoryError: CUDA out of memory. Tried to allocate 550.00 MiB. GPU 0 has a total capacity of 2.00 GiB of which 323.91 MiB is free. Of the allocated memory 674.42 MiB is allocated by PyTorch, and 25.58 MiB is reserved by PyTorch but unallocated. If reserved but unallocated memory is large try setting PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True to avoid fragmentation. See documentation for Memory Management (https://pytorch.org/docs/stable/notes/cuda.html#environment-variables)GPUの初期化までは成功しているものの、OCRの実行時に必要なGPUメモリを確保できず、処理が停止してしまった。
GPUを使用しない設定も試したが、この環境では期待どおりにCPU実行へ切り替わらず、安定して動作させることができなかった。
今回使用している検証用PCは、Windows 11ではあるものの、10年以上前の比較的古いハードウェアである。
そのため、GPU環境を前提とする構成ではなく、CPUのみで安定動作する環境を構築する方針へ切り替えることにした。
CPU版環境を再構築する
試行錯誤を繰り返した結果、Python環境やライブラリの構成が複雑になってしまった。
原因を切り分けるためにも、一度仮想環境を削除し、CPU版PyTorchを利用する構成で環境を再構築する。
## 環境構築コマンド:

# 1. プロジェクト用の新しいフォルダを作る(念のためデスクトップに)
cd C:\Users\(君のユーザー名)\Desktop
mkdir VGLL_SurfacePro
cd VGLL_SurfacePro

# 2. 仮想環境を作成して有効化
python -m venv .venv
.venv\Scripts\Activate.ps1

# 3. pipを最新にしておく
python -m pip install --upgrade pip

# 4. PyTorch CPU版(安定版)をインストール
pip install torch torchvision --index-url https://download.pytorch.org/whl/cpu

# 5. EasyOCRをインストール
pip install easyocr

# 6. さっきのspike.pyをこのフォルダに作成・保存して実行
python spike.py
この構成では、spike.py のコードを変更する必要はない。
EasyOCRは内部で利用するPyTorchを自動的に認識するため、CPU版へ切り替えた後も、同じコードのまま動作を確認できた。
こうして環境を一から見直した結果、ようやくOCRを実行できる状態までたどり着いた。では、ゲーム画面は実際にどのように認識されたのだろうか。
OCRはゲーム画面を読めたのか
環境を再構築した結果、ついにEasyOCRを実行できる状態までたどり着いた。
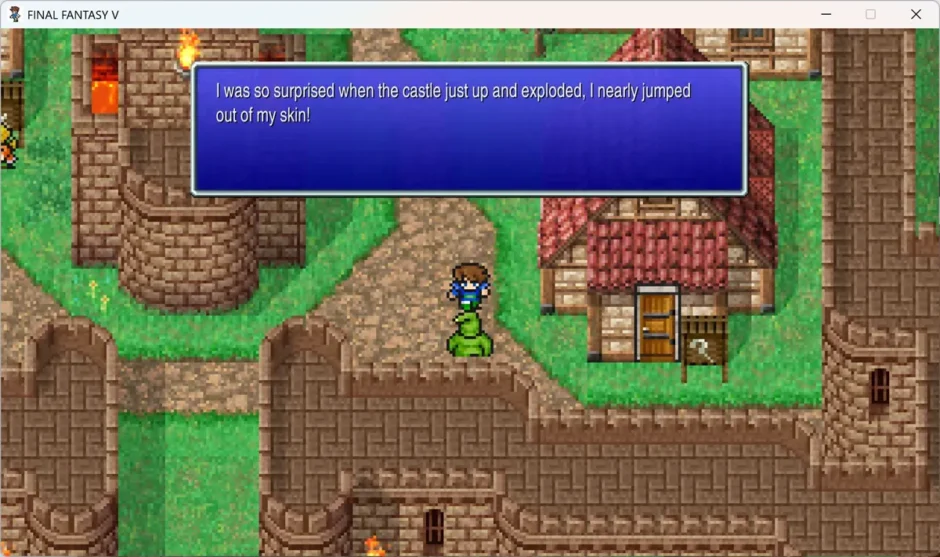
今回の検証では、ゲーム画面のスクリーンショットを入力し、OCRがどの程度文字を認識できるのかを確認する。
検証に使用した画像
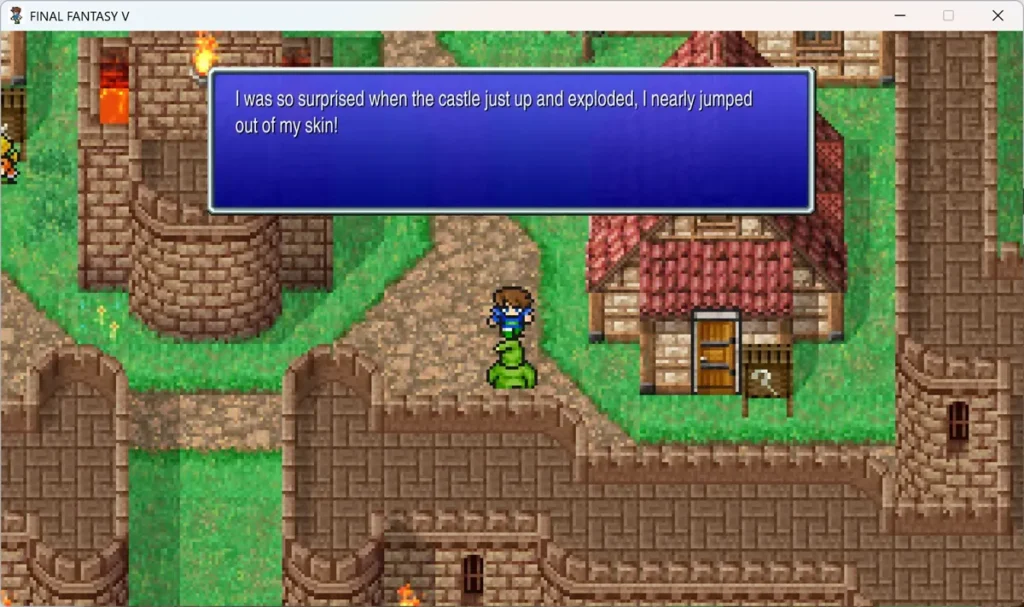
OCR実行ログ
2026-07-07 18:43:50,638 - Detected: FINAL FANTASY V | Confidence: 0.93
2026-07-07 18:43:50,640 - Detected: WasSo | Confidence: 0.74
2026-07-07 18:43:50,640 - Detected: suipiisedwhenthecasilejustupandexploded,Ineailyjumped | Confidence: 0.64
2026-07-07 18:43:50,640 - Detected: outofmyskin} | Confidence: 0.33
Confidence は、OCRが認識結果に対してどの程度の確信を持っているかを示す指標である。1.0に近いほど、その認識結果に自信があることを意味する。
検証結果
完全な認識とは言えないものの、ゲーム画面から文字情報を抽出できることは確認できた。
タイトルロゴの 「FINAL FANTASY V」 は高い信頼度で認識されている一方、会話テキストについてはスペースの欠落や文字の結合、誤認識が見られる。
これはゲーム特有のフォントやアンチエイリアス、背景画像とのコントラストなど、OCRにとって認識が難しい条件が重なっているためだと考えられる。
しかし、今回の検証で重要なのは100%正確に読み取れたかどうかではない。
ゲーム画面を画像として扱うのではなく、テキストデータとして取得できたことに大きな意味がある。
OCRが文字を認識できるようになったことで、このデータを翻訳や自然言語処理(NLP)、さらには学習履歴の生成へと活用できる可能性が見えてきた。
まとめ
今回の検証では、EasyOCRを利用してゲーム画面から文字情報を抽出するプロトタイプを作成した。
開発中にはPythonとPyTorchの互換性やCUDA関連の問題など、いくつかの環境依存の壁にも直面したが、CPU版環境を再構築することでOCRの動作確認まで到達できた。
もちろん、現時点では認識精度に課題は残っている。
スペースの扱いや誤認識、ゲーム特有のフォントへの対応など、実用化にはまだ改善の余地がある。
それでも、「ゲーム画面を画像ではなくテキストとして扱える」という最初の一歩を踏み出せたことは、VGLLの”眼”が、初めてゲーム画面を読むことに成功した。
次回は画像の前処理やOCRの設定を見直しながら、ゲーム画面に適した認識精度の向上を目指していく。